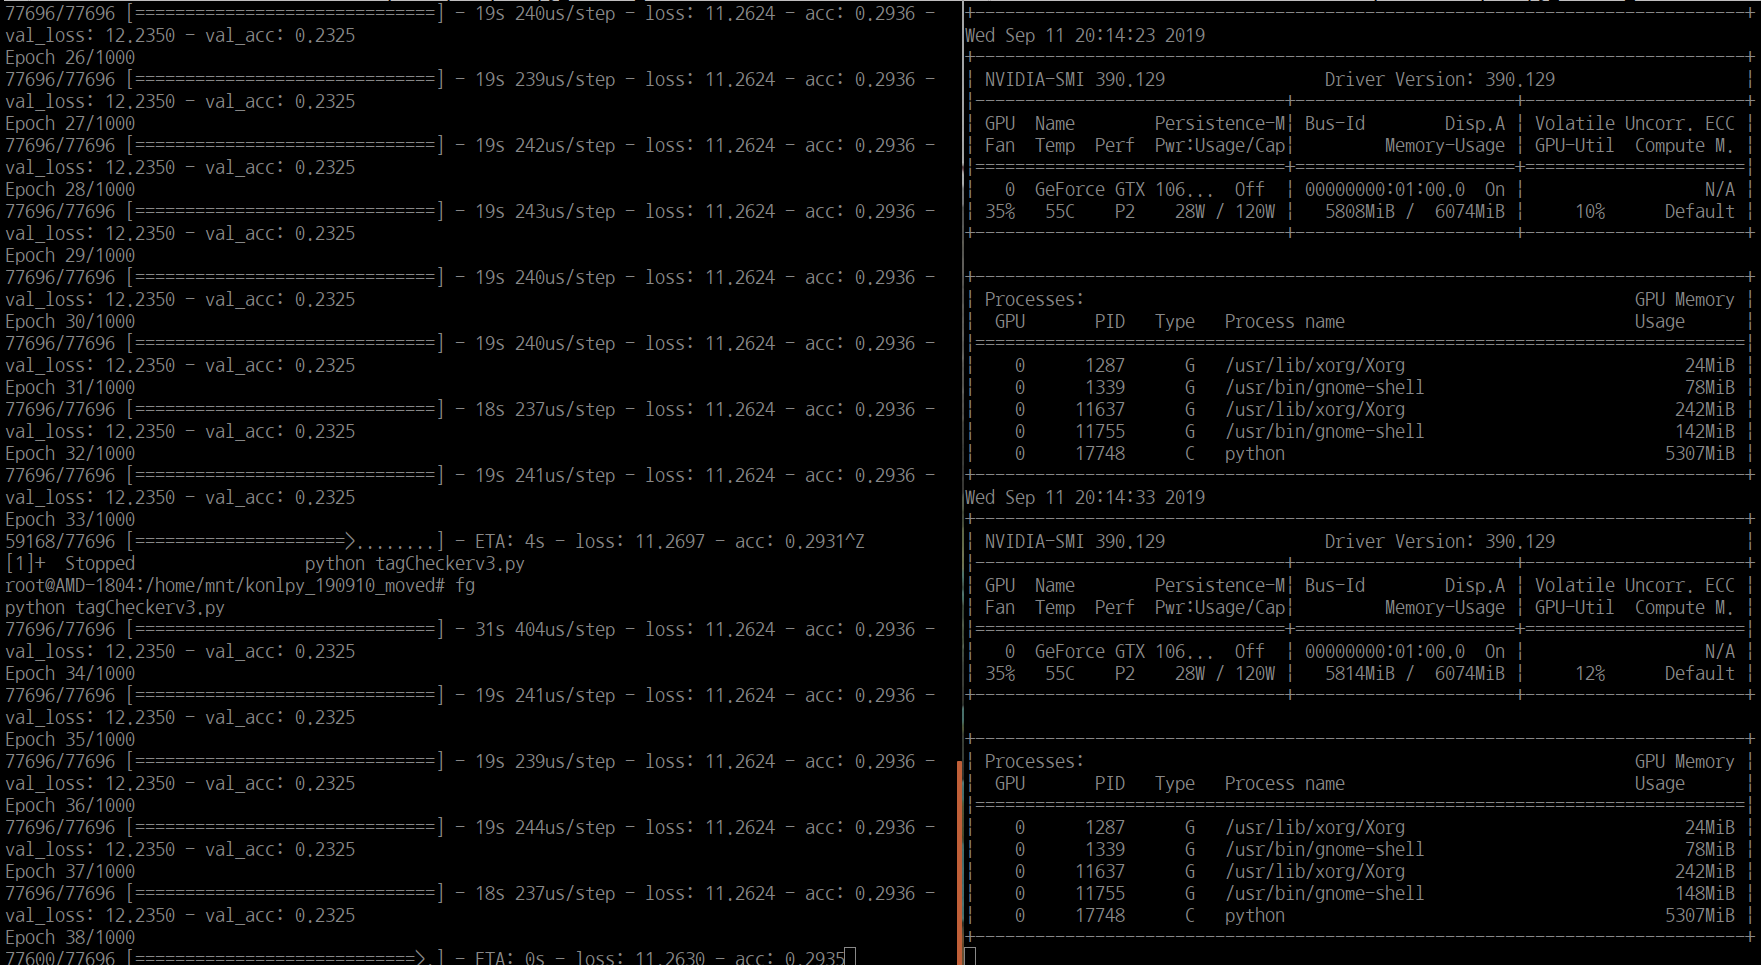
간단한 데이터(1,200개)로 태그 분류기를 만들었다. validation을 0.2로 설정하면 val_acc가 0.3에서 움직이지 않는다. 그러나 0.1로 바꾸면 0.99까지 올라가는 마법을 볼수있다. 데이터가 적어 많이 입력하면 어떨지 잘 모르겠다. 똥을 먹으면 똥을 싼다. 똥을 음식으로 바꾸려면 물, 비료도 주고 햇빛도 잘 쬐여야한다. 농사나 손가락 노가다나 별 차이없어 보인다. 모델을 저장해서, 다시 불러오는 방식으로 바꾸었다. 하도 많이 수정하다 보니 […]
카테고리
박시백의 조선왕조실록12:인조실록

isbn: 9788958628125 조선왕조실록을 1권을 읽기 시작하고 어느새 12권에 이르렀다. 누가 선조실록을 빌려가 빌려가 읽지 못했다. 모두가 임진왜란을 겪은 선조는 무능하다 알고 있다. 이순신, 권율 등 능력있는 인재와 대비를 이뤄 그 무능함은 더 두드러진다. 인조 역시 선조와 비슷한 무능한 왕이었다. 그 긴 재위동안 이룬 일 하나없고, 쓸데없는 전쟁으로 국민들 고생만 시켰다. 새롭게 떠오르는 청나라에 제대로 대응하지 […]
대박이다!! 1,000회를 돌렸는데 0.87 정확도를 보였는데, verb까지 검사하니 0.93에서 시작한다!! kkma가 동사로 끝나는 명사형 단어를 동사로 인식한다!! 사용자 입력을 받아들여 단어를 분석하는 부분을 아래와 같이 했다. 네트웍은 LSTM을 복잡한 형식으로 썼다. 네트웍 구조가 json으로, 웨이트가 h5로 저장된다. 나중에 네트웍 구조를 json으로 저장하고, json으로 부르는 부분으로 수정해야 겠다. 위에 “B220ST YD5 CLAMP 잠김”을 분석하면 아래로 분석한다. […]
과거 acc를 못 올리는 이유를 알아보았다. 둘 중 하나를 선택하는 문제는 activation softmax대신 sigmoid를 사용해야 한다. 아래로 고치고 1,000번 학습시켰다. 최고값을 찾은 weight를 파일로 저장했다. 147번 학습해보니 0.99?? 정확도를 보이나, vlaidation 체크용은 0.87대 정확도를 보인다. 1,000회 하는데 4~5시간정도 걸린 듯 하다. 그러나 불행하게도 weight는 초기에 한번 업데이트하고 말아버렸다. 그래도 이렇게 간단한 구조인데도 87%를 유지하니 좀 […]
keras가 지원하는 embedding을 어떻게 사용하는지 몰랐다. keras가 제공하는 문서가 embedding 기능을 정확히 설명한다. weight로 embedding_matrix를 입력하고, input으로 index를 입력하면 index를 vector로 변경한다. 따라서 아래와 같은 순서로 작업해야 한다. 미리 만든 word2vec 파일을 불러온다. 전체 vocab 총 양을 embedding_matrix로 설정한다. konlpy로 각 태그를 분리한다. 불러온 word2vec 파일에서 해당하는 단어 index를 구하고, 이를 문장으로 만든다. 적절한 길이로 […]